OpenAI Gym
url: https://github.com/openai/gym https://arxiv.org/abs/1606.01540
OpenAI Gym 是什么
Gym 是一个用于 强化学习(Reinforcement Learning,RL) 研究的Python Library
主要做两件事情:
- 提供API,统一环境
- 提供大一批适用这个接口的基准任务(benchmark problems)
强化学习:一个Agent 在一个环境Environment里反复做决策,每一个决策,也就是一个动作(action), 环境会有一些反馈(observation)和奖励(reward)。我们的优化目标就是让最大化每回合总奖励的期望。
action aₜ
Agent ─────────────▶ Environment
智能体 ◀───────────── 环境
observation oₜ₊₁, reward rₜ
以下是一个例子:
为什么会出现Gym?
以前的研究人员缺少一个最方便使用的软件包 对于不同的研究要些写不同适配的代码
- A 研究 CartPole,透过左右移动保持杆子平衡。
- B 研究 Atari 游戏,让 AI 学会玩游戏。
- C 研究机器人,让机械臂学会抓取物体
A 的环境
state = cartpole.start()
next_state, reward = cartpole.move_left()
B 的环境
game.initialize()
screen, score, game_over = game.press_button(2)
C 的环境
robot.restart()
sensors, reward, finished = robot.apply_torque([0.1, 0.2])
那如果我们引入了一个强化算法想套用到这三个任务上,那就会导致一个问题 也就是我们要写三套适配的算法,也就是重复造轮子。
所以我们需要引用gym 也就是标准化环境,也是不论环境内部多复杂,都必须允许 Agent 使用相同的方式与它交互。
Gym 最主要关注回合制(episodic setting)强化学习。每个回合会从一个随机初始状态或者设置确定的初始状态开始,然后会一直进行直到终止状态(terminal state)。
目标有两个:
- 每个回合的expected reward 要高
- 尽可能少回合学会
Gym最主要只规定了 env 的接口,没有规定agent的接口,这样做的设计是为了让开发者可以自由的选择在线学习(online learning) 或 批量学习(batch update)等风格。
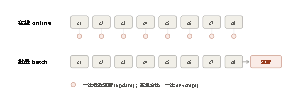
在线学习 (online learning):在线风格的 agent 每一步都接收(观察、奖励、done)并逐步更新
批量更新 (batch update):只接收观察,奖励由强化学习算法另外收集,之后再用来计算一次更新
设定——POMDP 和回合制
论文把环境形式化为部分可观测马尔可夫决策过程(Partially Observable Markov Decision Process,POMDP)
马尔可夫性质(Markov property) : 未来取决于现在 不取决于过去