BlackCat

building micrograd

从零搭建 micrograd:神经元、权重、bias、激活函数(ReLU)与反向传播的直观解释,配可交互函数图像。
Neural-Networks-Zero-to-Hero 12 min read

micrograd — BlackCat grayscale pixel cover

1. 项目简介

micrograd 是 Andrej Karpathy 所开源的一个 GitHub 学习项目,项目的初衷是让读者可以更好地学习 back propagation。Andrej Karpathy 本人也录制过一段 YouTube 视频来进行讲解(url: https://youtu.be/VMj-3S1tku0?si=6qfc4FQkdIn_WmnL),那么为了理解 micrograd,我们需要先从最基础的神经网络开始讲起。

2. 神经网络基础

2.1 神经元与权重

神经元就是一个 $f(x_1,x_2,x_3,...)$,一个函数,输入了一堆数字。

然后每个 input 都会跟着一个 weight 权重,就是,最主要是一个常数。

高就代表这个输入很重要;低就代表没那么重要。

当然也要看正负,可以看出是负影响,还是正影响。

2.2 神经元的基本结构

基本结构:

$$f(x_1,x_2,x_3,...) = Activation\_function(w_1 \times x_1 + w_2 \times x_2 + ... + bias)$$
神经元的基本结构

2.3 bias 的作用

这里可以看到,在刚刚输入 × 权重后,还要加一个 bias。

而 bias 的作用是什么?为什么 + 一个 bias 呢?

bias 从几何意义上来理解:

$$y = mx + c$$

c 也就是代表着这条线可以在整个空间里面平移。

机器学习,最主要是学习数据关系,也就是输入和输出的对应关系。

如果不允许平移,那么,如果真实数据里面是 $y = 2x + 100$,在输入永远 = 0 的时候,如果没有 bias,永远拟合不了线性的真实数据。

而我们最终的目的也就是,确保 x 轴上每一个 x,只要调整 w 和 bias,可以触及任意的 y。

因为我们要拟合世界上任意的对应关系,任何的数据形态。

2.4 Activation function 与 ReLU

但是单单只有一条直线,是不够的,所以我们要引入 非线性。

也就是 Activation function(激活函数)。

我们先介绍第一种 Activation function,ReLU:

其实也就是创造一个折点,在几何意义上。

2.5 神经网络的连接结构

那我们现在画一个最简单的神经网络,长这样(2 个输入、3 个隐藏神经元、1 个输出):

最简单的神经网络:2输入 3隐藏 1输出

每条连线就是一个权重 w,每个神经元做的是加权求和,再过一个 Activation function。

2.6 线性变换的局限

为什么一定要非线性?

如果每个神经元都只是线性加权求和,那不管叠多少层,组合起来还是一条直线:

\(y = mx + b\)
m(斜率)1
b(y截距)0.5

拖动左边 m、b 的滑条,怎么调都只是一条直线,永远拟合不了 $\sin(x)$。

2.7 多个 ReLU 的组合

但是只要加上 ReLU 这种非线性,把几个 ReLU 加起来,曲线就开始拐弯了:

\(y = \sum_{i=1}^{4} c_i \max(0, x - p_i)\)
c₁1
c₂-0.8
c₃0.5
c₄-0.3

拖动 $c_1$ 到 $c_4$ 的滑条,可以看到分段线性的曲线可以一点点逼近 $\sin(x)$。

神经元的数量越多,拐弯的点越多,就能逼近越复杂的函数。

这就是为什么神经网络一定要加 Activation function。

3. micrograd 与 backpropagation

简单介绍完基本的神经网络结构,就可以来说一下 micrograd 了。

3.1 autograd engine

micrograd 是一个 autograd engine,就是自动梯度的机器。

  • 也就是 Implement backpropagation,向后传播。

3.2 从输入、输出到 Loss function

backpropagation 向后传播解释

整个 Neural Network 的目的,例如说,我们想要这个神经网络去拟合一种数据分布,对吧?

首先整个的流程就是:

Feed input -> Process -> Output

然后看看结果如何。

那如何衡量结果?我们就需要 loss function。

有了 loss function 之后,知道做得好不好了。

我们就需要去改良(也就是去调整权重和 bias)。

从输入、输出到 Loss function

3.3 Mean Squared Error(MSE)

举出一个简单的例子:

Mean Squared Error - MSE

$$MSE = \frac{1}{n} \sum_{i=1}^{n}(y_i-\hat{y}_i)^2$$

3.4 gradient 与 chain rule

有了 Loss function 之后,我们的步骤就到了如何改进。

那么改进,需要 gradient(梯度)。

梯度的意思就是在那一变量的对整个函数的影响,就是,如果增加一个无穷小量 $dx$,如何影响整个函数。

让 $L$ 作为 Loss function。

$\frac{dL}{dL}$ 是 1。

$$L = \tanh(wx + c)$$
$$\frac{dL}{dw} = \frac{dL}{d(wx+c)}\frac{d(wx + c)}{dw}$$

只要用微积分的法则,例如多变量微积分是将其他的变量当成常数,嵌套函数就是 chain rule,就可以算出某个具体变量的梯度。

3.5 学习率与最小化 Loss

知道梯度是 $x$ 增加一个 $dx$,$y$ 的上涨。

那么为了最小化 $L$,可以学习率乘一个负导数。

因为 $x$ 如果 $+dx$ 是增加 $L$,那么 $-dx$ 就是减少 $L$,这样可以让 Loss function 变小。

而学习率就是变小多少,防止直接跳过了 minimum。

4. Python 与 Value 类的实现

实践

在 Python 里面,我们最主要使用 OOP(Object-Oriented Programming)。

我们要从最小的部分开始(分治法)。

4.1 初始化:__init__

创造一个名为 Value 的 class。

class Value:
def __init__(self, x, _children=()):
self.data = x
self.grad = 0.0
self._backward = lambda: None
self._prev = set(_children)

在初始化一个 Value 的时候,它就是类似一种新的 data type,是用来装数值的。

4.2 加法:__add__

并且我们要定义加法减法,等等,让 Python 可以识别我们对于这种自创的 class 的操作。

def __add__(self, other):
other = other if isinstance(other, Value) else Value(other)
out = Value(self.data + other.data, (self, other))

def _backward():
self.grad += 1.0 * out.grad
other.grad += 1.0 * out.grad
out._backward = _backward
return out

这里 isinstance 就是判断 other 是不是 Value 这个类的,不是我们就转换成 Value,我们这个自定义的 class。

Value 的第二个参数就是提供一个可以追溯的,因为我们最后要做 Back propagation,所以就是我们会需要我之前做过每个操作的 history。

这里的 backward 也很容易理解,就是基本的微积分。

x = a + b # x 是新的

那么如何算 dx/da?那就是 treat other as constant。

所以是:

$$dx/da = 1 + db/da = 1.0$$

那 out.grad 是怎来?因为我们最终是要 dL/da。

所以 out.grad 就是 dL/dx * dx/da = dL/da,所以 dL/da = 1 * dL/dx,这里的 dL/dx 就是 out.grad。
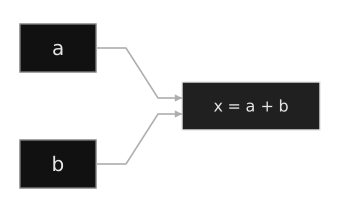
加法:__add__

4.3 对象表示:__repr__

def __repr__(self):
return f"data is: {self.data}"

纯粹是,我们如果直接 call x 的时候,会出现什么。

4.4 乘法:__mul__

def __mul__(self, other):
other = other if isinstance(other, Value) else Value(other)
out = Value(self.data * other.data, (self, other))

def _backward():
self.grad += other.data * out.grad
other.grad += self.data * out.grad
out._backward = _backward
return out

mul 也是和 add 一样,不过转成了乘法。

还是推理一下:

x = a * b

dx/da = b

dL/dx * dx/da = dL/da
b * out.grad = dL/da

4.5 取负:__neg__

def __neg__(self): # -self
return self * -1

这里是 negative,也就是 -self。

4.6 减法:__sub__

def __sub__(self, other): # self - other
return self + (-other)

这里 subtract 的话就不用再写一遍了,直接套用 + 的那个方法就行。

4.7 反向减法:__rsub__

def __rsub__(self, other): # other - self
return other + (-self)

定义 other - self。

4.8 反向乘法:__rmul__

def __rmul__(self, other): # other * self
return self * other

4.9 反向加法:__radd__

def __radd__(self, other): # other + self
return self + other

4.10 激活函数:tanh

def tanh(self):
x = self.data
t = (math.exp(2*x) - 1) / (math.exp(2*x) + 1)
out = Value(t, (self, ))

def _backward():
self.grad += (1 - t**2) * out.grad
out._backward = _backward
return out

然后是 tanh 这个方法,就是加个 activation function,引入非线性,稍微推理一下:

x = tanh(a)

dx / da = d/da tanh(a)

wiki : https://en.wikipedia.org/wiki/Hyperbolic_functions

tanh(a) 的导数 wiki 有,所以是 1 - tanh(x)^2。tanh 又是由 $e$ define 的,所以我们从 math lib 引用一些函数用来组成 tanh,当然这里转 ReLU 那些都行。

4.11 然后就是最重要的方法:backward

def backward(self):

# topological order all of the children in the graph
topo = []
visited = set()
def build_topo(v):
if v not in visited:
visited.add(v)
for child in v._prev:
build_topo(child)
topo.append(v)
build_topo(self)

# go one variable at a time and apply the chain rule to get its gradient
self.grad = 1
for v in reversed(topo):
v._backward()

backward 首先我们创造了 topo 一个 list 和 visited 一个 set。为什么要用 set?首先我们需要获取所有的 child,也就是需要做 gradient 的 child,set 是不重复的,收录所有的 child,可以确保 child 只看了一次。

然后我们就开始进行 topological order,也就是从 output 开始,最顶端 output 的 child,再到 output child 的 child(这里使用了 recursion function calling itself)。

例如我 x = a + b,那么 topo 里面会有 a, b, x。

topo 里面是有 order 的,set 是无 order,并且只记录一次的(确保所有 node 遍历过)。

因为它是处理完 child 之后才会处理自己,topo.append(v) 在 for loop 后面,然后 for loop 里面有 recursion,是处理 for loop 里面的 recursion 先,然后就导致我们的 list,x 是在最后的。

然后我们因为要从最顶端开始,所以是 reversed,从顶端的 output,然后因为 node gradient 已经有了,我们定义过 dL/dL = 1,然后利用 local derivative + chain rule,计算 child 的 gradient,这样。

topological_sort_backprop_stepper.html

这里在做的是 topological sort,因为整个 back propagation 是有向无环图 DAG (Directed Acyclic Graph)。

以上就是整个 engine 的代码解析。

5. 那么我们如何制作一个最简单的神经网络来进行 back propagation 呢?

from Engine import Value
import random

制作最基础的神经元

class Neuron:
def __init__(self, nin):
self.w = [Value(random.uniform(-1, 1)) for _ in range(nin)]
self.b = Value(random.uniform(-1, 1))
# 这里是首先初始化就是给予随机数值

def __call__(self, x):
out = sum((x1 * w1 for x1, w1 in (zip(x, self.w))), self.b)
return out.tanh()
# tanh(wx + wx + b)

def parameters(self):
out = self.w + [self.b]
return out
# 可以调的参数 只有 b 和 w 可以调 x 是输入
class Layers:
def __init__(self, nin, nneu):
self.n = [Neuron(nin) for _ in range(nneu)]
# nin 是多少个输入 就是一个神经元的多少个 x 然后 nneu 是多少个神经元

def __call__(self, x):
out = [ni(x) for ni in self.n]
return out
# 输出是一个 list 储存各个神经元的输出

def parameters(self):
out = [p for i in self.n for p in i.parameters()]
return out
# for i in self.n 这里的 i 是每个神经元 i(x) = 神经元(x) 然后再来一个 for p in i.parameters 就是从每个神经元中拿出其可以修改的参数

我们需要可以弄一个每个 layer 几层几层,因为可能我们最后只需要输出一个值这样。

class MLP:
def __init__(self, nin, nouts):
sz = [nin] + nouts
# list 的拼接 那么 nin 是神经元的输入数量 nouts 是每个 layers 有多少个神经元 例如 [4, 4, 1] 就是第一层 4 个 第二层 4 个 最后一个
# 我们拼接出来例如说是 [3, 4, 4, 1]
self.layers = [Layers(sz[_], sz[_+1]) for _ in range(len(sz) - 1)]
# 然后开始做初始化 那么我们要创造 layers Layer 的每一层的输入 是上一层的神经元(输出数量) 所以我们要做 for loop 来就是对 list 进行增加
3 -> 4 -> 4 -> 1
def __call__(self, x):
for layer in self.layers:
x = layer(x)
return x
# __call__ 调用的时候 例如 MLP(x)

def parameters(self):
out = [p for i in self.layers for p in i.parameters()]
return out
# 获取 parameters 当成一个 list
# 1. 建立我们的神经网络模型 (MLP)
# 输入特征是 3 个,然后经过两个各 4 个神经元的隐层,最后输出 1 个数
n = MLP(3, [4, 4, 1])

# 我们可以看看总共有多少个参数
print(f"Total parameters: {len(n.parameters())}")

# 2. 准备数据集 (随便写的 :P)
Training_data = [
[2.0, 3.0, -1.0],
[3.0, -1.0, 0.5],
[0.5, 1.0, 1.0],
[1.0, 1.0, -1.0],
]
y_expe = [1.0, -1.0, -1.0, 1.0] # 每个 x 对应的期望输出目标

# 我们先做一次前向传播,看看没经过训练的网络会输出什么乱七八糟的结果
y_pred = [n(x) for x in Training_data]
print("初始未训练时的预测值:")
print(y_pred)

for k in range(20):
y_pred = [n(x) for x in Training_data]
loss = sum((yout[0] - ygt) * (yout[0] - ygt) for ygt, yout in zip(y_expe, y_pred))
for p_i in n.parameters():
p_i.grad = 0.0
# 设置每个 parameters 的 gradient
loss.backward()
# 然后开始做 backward 给每个 parameter assign gradient

for p_i in n.parameters():
p_i.data += -0.01 * p_i.grad
# 这里的 0.01 就是 learning rate 了 然后 - 就是我们说的走 slope 的反方向!
print(f"step{k} loss:{loss.data}")

y_pred = [n(x) for x in Training_data]
y_pred

Keep reading

View all